Introduction : le difficile cas du texte
La détection de contenus générés par l’IA fonctionne assez bien pour les photos, vidéos ou sons (détection de deepfake ou d’hypertrucage). Pour ces 3 médias, les algorithmes de détection peuvent retrouver des traces résiduelles du moteur d’IA générative dans les productions. Ces artéfacts sont des preuves irréfutables de l’origine artificielle de la création [1].
Pour les textes en revanche, c’est beaucoup plus difficile. Car la sortie d’une IA générative est un ensemble de mots (beaucoup moins nombreux que le nombre de pixels d’une photo) et dont l’agencement (une phrase, un paragraphe) pourrait être d’origine humaine ou artificielle, sans réelle différence perçue à sa lecture.
Au mieux, les outils de détection de textes générés par une IA générative vont donner des indices, des hypothèses, mais en aucun cas des preuves.
Même si le taux de faux positif (un texte est classifié IA alors qu’il a été écrit par un humain) peut être faible, l’impact d’une telle erreur sur un article universitaire ou sur un texte littéraire peut être hautement préjudiciable pour la carrière de son auteur.
Du point de vue éthique, se fier uniquement à ces détecteurs n’est donc pas recevable.
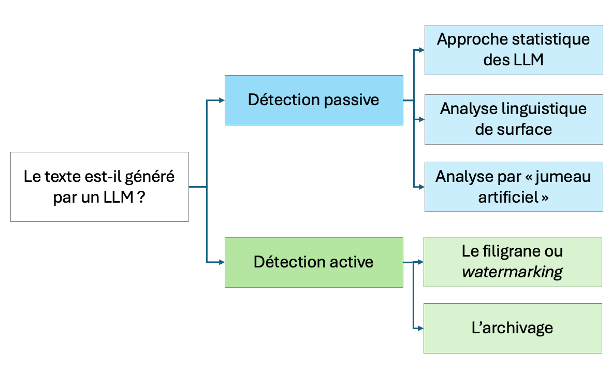
Cet article vulgarise les principaux types d’outils de détection de textes générés par IA.
Les algorithmes à détection passive
Il s’agit d’analyser un texte a postériori pour y trouver des propriétés caractéristiques d’une IA générative.
Les analyses basées sur l’approche statistique des LLM
Dans un contexte donné, les modèles de langages (LLM) construisent les phrases en choisissant les mots les plus probables, les uns après les autres.
La perplexité d’un texte mesure à quel point une suite de mots est probable ou pas. C’est une valeur directement liée à la probabilité attribuée à chaque mot.
Comme les LLM privilégient les mots statistiquement plus fréquents, ils sont souvent associés à une perplexité faible et constante.
Un texte écrit par un humain aura en revanche une perplexité variable par paragraphe (tournures originales, fautes, mots rares, rythmes différents, …)
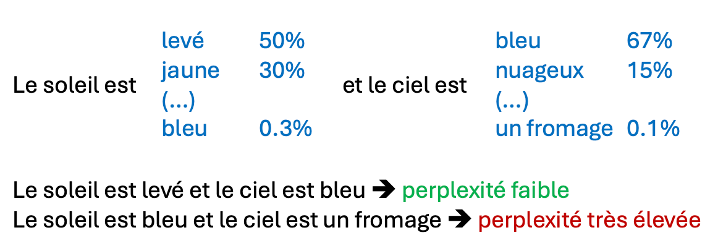
Les premiers détecteurs d’IA fonctionnaient généralement sur ce principe. Les problèmes sont nombreux :
- Pour les articles universitaires, si l’anglais n’est pas la langue maternelle, le texte aura une perplexité faible (richesse de vocabulaire moins importante et structures de phrases plus simples)
- Certains textes formels, techniques ou normés (juridiques, rapports médicaux, documentations techniques, …) ont par construction une perplexité faible.
- Ces détections dépendent fortement du modèle de référence. Or, les moteurs LLM sont nombreux et évoluent constamment ce qui rend l’évaluation de la frontière humain/IA très délicate.
- Cette méthode n’est pas adaptée aux textes courts (il faut un échantillon suffisant pour moyenner la perplexité de plusieurs paragraphes).
GPTZero est connu pour utiliser la perplexité dans son analyse.
DetectGPT optimise cette méthode en modifiant légèrement le texte à plusieurs endroits. Si la perplexité augmente fortement, c’est que le texte se trouvait dans « un optimum de perplexité » propre à un LLM.
Sur les réseaux sociaux, de nombreuses personnes dénigrent ce genre de détecteur en dénonçant le verdict erroné pour la Bible ou pour des poèmes de Victor Hugo.
Il faut savoir que les LLM ont été entrainés sur ces textes ultra-classiques et qu’ils en gardent quelque part une trace. Chacune des séquences de mots a été vue des milliers de fois et leur probabilité d’apparition n’a donc rien de surprenant. Ces documents sont donc facilement assimilables à des générations artificielles, puisqu’ils ont été à la base de leur entrainement. C’est un effet secondaire induit à ne pas négliger.
Les analyses linguistiques de surface
Basées sur les « tics »
Ici on analyse le texte : sa ponctuation, son style, son vocabulaire, dans l’espoir de trouver des « tics » d’un LLM.
Ces tics peuvent être syntaxiques, comme une trop forte proportion de tirets cadratins (— ), les mauvais guillemets en français “, des listes avec des smileys, etc.
Cela peut être aussi une sur-représentation de certains mots ou expressions en fonction des modèles de langage : (« Incontournable », « crucial », « en guise de conclusion », « il est important de noter », …)
Ou encore des répétitions abusives, des tournures de phrases systématiques (rythme ternaire), etc.
Basées sur la façon d’écrire
De façon plus subtile, l’analyse peut également se faire sur des mesures de richesse lexicale, de complexité syntaxique, de densité de paragraphes, de rythmes de phrases répétées. Cet article « Why AI-Generated Text Detection Fails » (https://arxiv.org/pdf/2603.23146) [3] propose d’analyser un texte grâce à 38 dimensions (comme le nombre de mots par phrase, le taux de répétition, la complexité des phrases, …). Basé sur des corpus de millions de livres écrits par une IA ou par un humain, l’algorithme entraine un modèle d’apprentissage supervisé à classifier l’origine du texte (Humain vs IA).
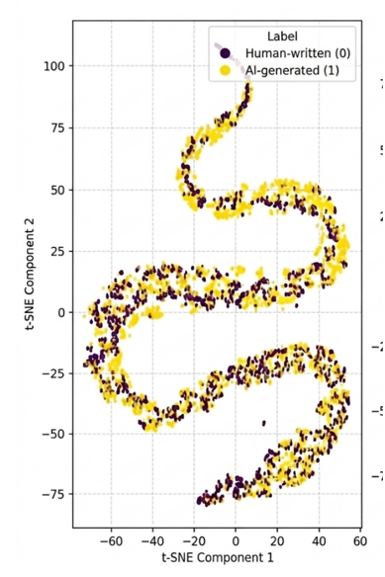
Même si le taux de faux-positif est correct (parfois moins de 1%), l’article explique que l’algorithme apprend surtout les motifs du corpus d’entrainement, plutôt que de véritablement reconnaitre l’origine d’un texte. Sur des textes vraiment différents du corpus d’apprentissage, les performances chutent (signes de surapprentissage).
« Together, these findings indicate that many detectors rely on dataset-specific stylistic cues rather than stable indicators of machine authorship. Consequently, benchmark accuracy alone is not a reliable measure of real-world detection capability. »
Et de conclure « The detector should therefore be viewed as an assistive analytic tool rather than an automated decision system ». La méthode de détection proposée dans l’article devrait être vue comme une aide à décider, plutôt qu’un système de classification automatique.
Les analyses par « jumeau artificiel »
Le principe est d’avoir un large corpus de textes écrits par des humains. Pour chacun des textes, l’on va créer son « jumeau artificiel », généré par un LLM en lui spécifiant de respecter la longueur, le thème, le style, etc.
Ainsi, on va se retrouver avec deux corpus de textes similaires, l’un généré par des humains, l’autre par des LLM.
Ensuite, on applique des algorithmes classiques de classification (apprentissage supervisé – Machine Learning) pour faire apprendre le modèle : Humain vs IA.
C’est le principe du détecteur Pangram, tel qu’expliqué sur leur blog ici et là
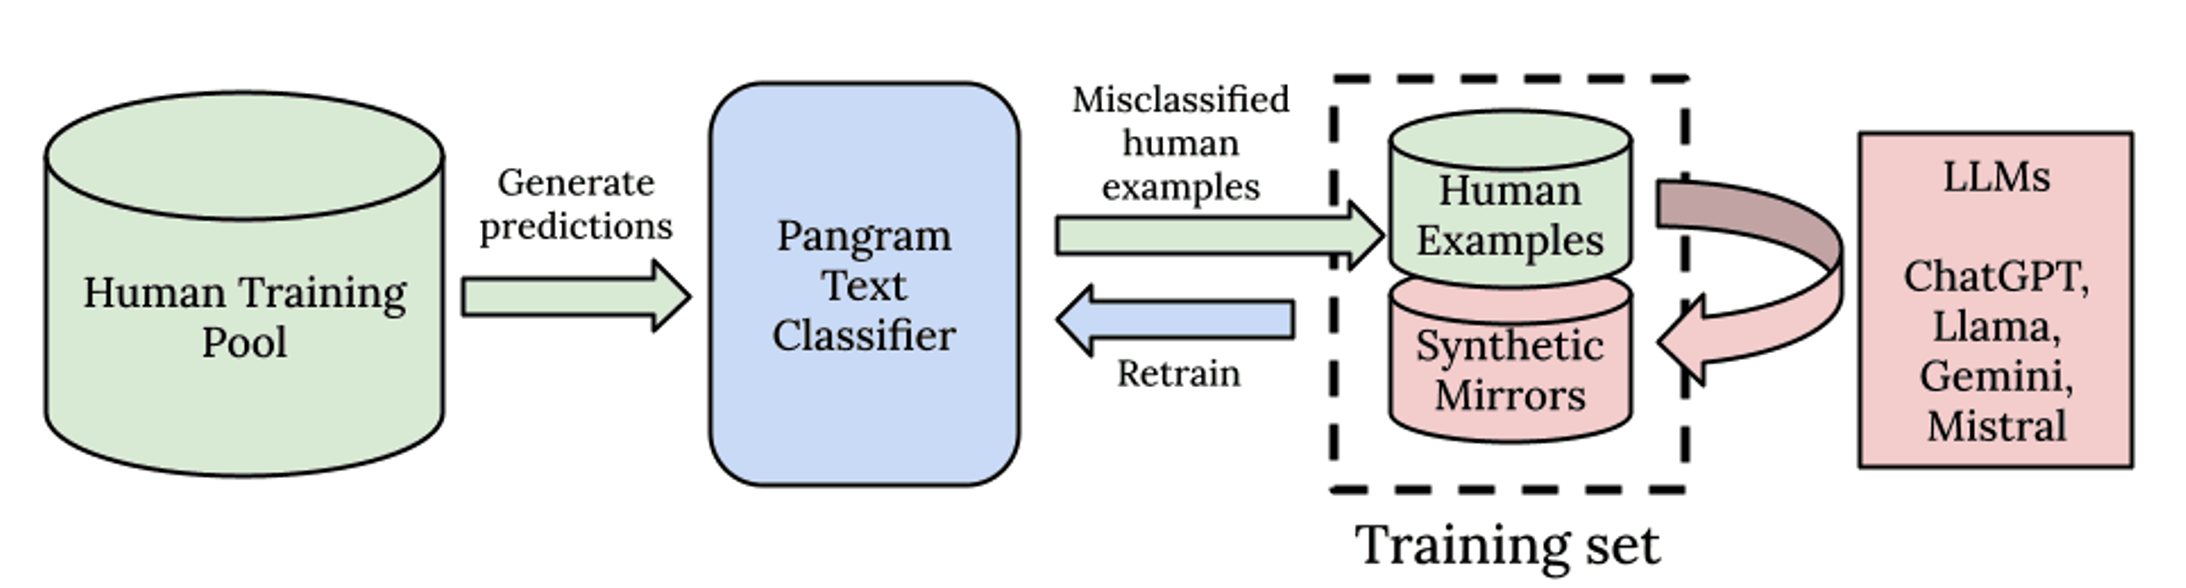
Il est probable que le verdict se base également en partie sur les autres méthodes évoquées plus haut.
Selon le blog de Pangram, le taux de faux-positif est inférieur à 0,2%. Il faudrait cependant savoir si l’algorithme de classification a réellement appris les motifs d’écriture intrinsèques aux humains ou seulement ceux du corpus.
Là encore, il est sage de considérer le verdict comme un indice, et surtout pas comme une preuve infaillible.`
Les algorithmes à détection active
Ces méthodes nécessitent d’intervenir à la génération du texte. Elles sont donc à l’initiative des fournisseurs de LLM.
Méthode à base de filigrane (watermarking)
L’idée est de placer un marqueur caractéristique du modèle de langage (LLM) à la génération du texte. On parle de « watermarking » ou « filigrane » en français (ou aussi tatouage numérique)
Une exigence Européenne
Depuis cet été, le règlement Européen sur l’IA (« IA Act » UE-2024/1689) exige que toute production IA soient filigranée.
Extrait de l’article 50, paragraphe 2.
« 2. Les fournisseurs de systèmes d’IA, y compris les systèmes d’IA générative, qui produisent des contenus textuels, audio, photographiques ou vidéo veillent à ce que les sorties du système d’IA soient marquées dans un format lisible par machine et détectables comme étant générées ou manipulées artificiellement. »
Pour les textes, les LLM doivent également se mettre en conformité. Par exemple le site d’Anthropic explique comment le watermarking est appliqué sur leurs modèles.
La « recette de fabrication » du watermarking étant secrète, Anthropic propose un service pour vérifier si un fichier a été généré par un de ses modèles : https://claude.com/check-files
Comment cela fonctionne ?
En langue française, chaque mot est associé à une probabilité d’usage (une fréquence d’utilisation dans des millions de textes).
Le modèle de langage va sélectionner quelques mots dont il va arbitrairement modifier la probabilité d’usage dans la génération de textes.
Sur des textes longs, la présence du filigrane va donc se détecter en analysant la fréquence d’apparition des mots choisis. Statistiquement, plus le texte est long et les écarts avérés, et plus la probabilité d’avoir affaire à un texte généré par LLM sera grand.
Le choix des mots dont les probabilités sont modifiées dépend du modèle. Ainsi, la signature invisible composée de ces fréquences inhabituelles reste secrète pour chaque éditeur afin d’éviter d’effacer ce marquage. L’objectif est de rendre « l’humanisation » d’un texte complexe.
Ce système est efficace pour les textes longs et surtout, si le texte généré n’est pas modifié ou à la marge. Autre avantage, ce système est indétectable pour un humain et préserve la sémantique du texte.
L’archivage
Le fournisseur de modèle d’IA conserve toutes les productions de son LLM. Pour vérifier un texte, il « suffit » de vérifier s’il existe dans la base historique (ou si des portions très similaires sont retrouvées).
Cette méthode pose des problèmes de confidentialité, mais surtout d’opérabilité car il faut stocker d’immenses volumes de données.
Conclusion
Nous avons vu quelques techniques de détection de textes générés par LLM. À ce jour, aucune d’elles n’est 100% précise et ne donne de preuves indiscutables. Trop souvent, les systèmes détectent des motifs dans le corpus d’apprentissage, mais qui ne sont pas des motifs intrinsèquement liés à une écriture humaine. Par ailleurs, le fait d’avoir entrainé les LLM avec des textes humains peut perturber la reconnaissance. Enfin, les « tics » de certains modèles de langages apparaissent et disparaissent au gré des versions.
Au vu des impacts potentiels d’une mauvaise classification, il faut rester extrêmement prudent sur le résultat de ces outils.
Mon avis est qu’il faudrait privilégier un label de confiance (du genre Fabrication Humaine [6]) qui engagerait l’auteur ou l’autrice sur l’origine humaine d’une production. Une sorte d’auto-certification beaucoup plus engageante en cas de violation constatée.
Pour aller plus loin / Références
[1] Post LinkedIn de Nicolas Bodin, société Label4.AI (spécialisée en détection de deepfake), qui parle de la délicate question de détection d’un texte généré artificiellement : https://lnkd.in/p/ec47kvXW)
[2] Détection de texte générée par l’IA : un examen complet des approches actives et passives : https://www.sciencedirect.com/org/science/article/pii/S1546221826000482
[3] « Why AI-Generated Text Detection Fails » (https://arxiv.org/pdf/2603.23146)
[4] « AI detecting AI in academic writing: Why most AI detector findings are false » https://www.sciencedirect.com/science/article/pii/S305047592600093X
[5] Comment fonctionne Pangram : https://www.pangram.com/blog/technical-report-february-2024 et https://www.pangram.com/blog/how-does-pangram-work


Bonjour Pierre,
Merci pour ces précisions. J’ai lu le roman de Thélyson Orélien au moment où la polémique a éclaté. Pour ma part, je l’ai beaucoup aimé.
Bonne continuation.